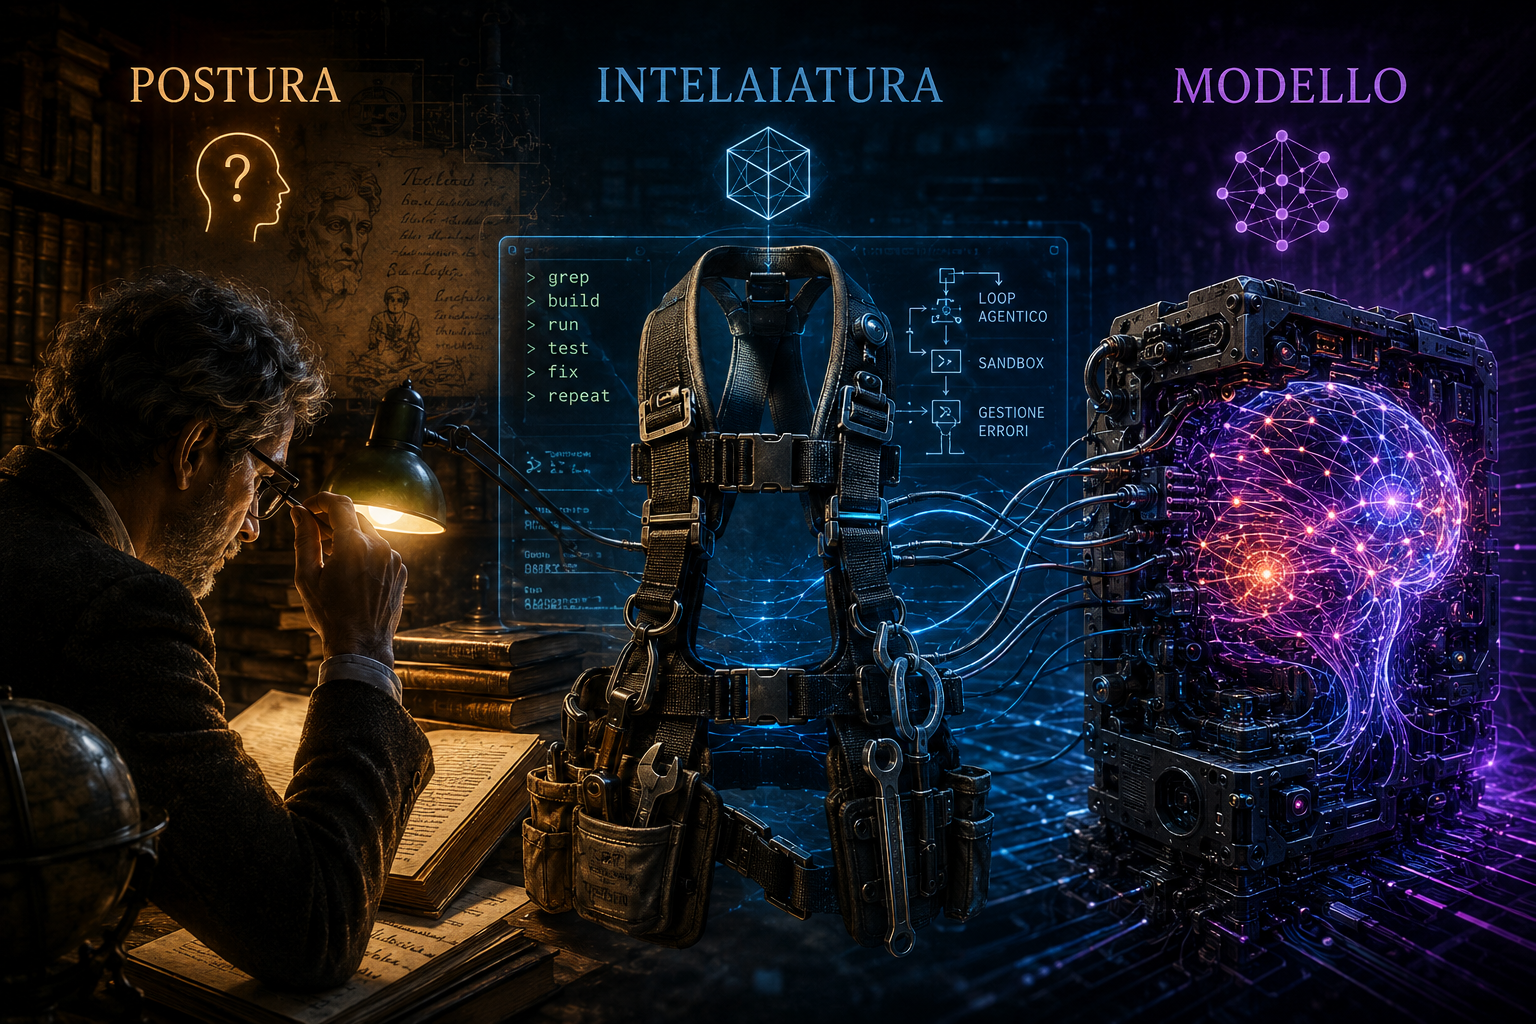
Nel 2023 confrontavamo i modelli. Ora confrontiamo le imbracature.
Maggio 2023: LMSYS apre Chatbot Arena, nove modelli in lista, 4.700 voti raccolti in una settimana. Tre anni dopo il contatore ha superato il milione di battaglie anonime, e il verbo che tutti usavano era uno solo: confrontare. GPT-4 contro Claude, Claude contro Gemini, chi risponde meglio alla stessa domanda alla cieca. La domanda sottintesa era sempre quella: qual è il modello più intelligente?
Questo pomeriggio ho fatto girare quattro agenti — Codex, Claude Code, Antigravity, Pi — sullo stesso repository, con lo stesso compito: trovare bug in un fork C# di OpenSimulator che uso per un progetto di NPC virtuali. Stesso codice, stesso prompt di partenza, modelli di classe sostanzialmente comparabile sotto il cofano. I risultati non potevano essere più diversi, e non per un motivo che un’arena a voti avrebbe mai potuto catturare.
Codex ha trovato un buco di autorizzazione reale nel modulo Groups — nessun controllo sull’identità di chi chiama, in un punto d’accesso che potrebbe essere raggiungibile da un’istanza federata. Antigravity ha lanciato la compilazione sul serio, ha beccato il blocco (il progetto punta a un SDK .NET che sulla macchina non c’era) e ha isolato un rischio di refcounting nella cache di compilazione degli script. Claude Code ha scovato che i benchmark di prestazioni non ancora versionati nel repository contraddicevano i numeri già pubblicati nella documentazione ufficiale del progetto — il fork mentiva a sé stesso, in pratica. Pi, alla prima richiesta, ha prodotto un riassunto pulito e completo di tutto quello che il progetto aveva già scritto su di sé. Utile, ordinato, e zero di nuovo. Codex, va detto, ci ha messo anche a inciampare da solo: un programma di supporto per la sandbox rifiutato su Windows, un paio di comandi cancellati a metà prima ancora di essere eseguiti. Non è un dettaglio da nascondere per pudore — è la prova che nessuno dei quattro procede in modo lineare, e che il risultato finale dipende tanto dalla capacità di recuperare quanto da quella di partire bene.
Qui la faccenda si fa interessante. Non ho cambiato modello per la seconda prova su Pi — ho cambiato il prompt. Gli ho chiesto di non fidarsi della documentazione, di cercare contraddizioni tra quello che il codice fa e quello che i file dicono, e di verificare con grep e compilazione invece di leggere e basta. Stesso agente, stesso repository, risultato radicalmente diverso: ha trovato una race condition reale nella coda eventi del motore di scripting — una finestra temporale in cui un evento arriva esattamente tra due controlli e sparisce per sempre, senza errore, senza traccia. E ha fatto di più: ha contestato un commento nel codice sorgente che dichiarava esplicitamente che quel pattern concorrente non poteva mai perdere un elemento vivo durante l’eviction — e ha dimostrato, tracciando l’interleaving dei thread, che il commento era falso.
Non è cambiata l’intelligenza sotto. È cambiata la postura verso il materiale che gli ho messo davanti.
Vale la pena separare bene i tre livelli, perché nella foga li ho accorpati in uno solo. Il modello resta la capacità di ragionamento sotto il cofano. L’intelaiatura è ciò che gli mette in mano — strumenti, ciclo di esecuzione, gestione dei fallimenti: la stessa che ha permesso a Codex di riprendersi da un comando bloccato invece di arenarsi lì. La postura è un terzo elemento ancora, distinto dagli altri due: l’atteggiamento verso le fonti che quell’intelaiatura gli lascia assumere. Tra le due prove su Pi il modello non è cambiato, e nemmeno l’intelaiatura — è cambiata solo la postura, imposta con una frase nel prompt. Il che vuol dire che oggi, a parità di strumenti in mano, un’intelaiatura può ancora oscillare da bibliotecario a filologo diffidente semplicemente su richiesta: non è un tratto fisso di carattere, è una leva che chi scrive il prompt aziona o lascia inerte.
Dentro la postura, poi, si nascondono due competenze diverse che l’etichetta unica di “analisi” confonde. Spiegare un progetto esistente — ricostruire un modello coerente a partire da quello che altri hanno già scritto — è un compito quasi da bibliotecario: si misura sulla chiarezza, sulla gerarchia tra ciò che è centrale e ciò che è dettaglio, sull’assenza di rumore. Trovare un bug che nessuno ha ancora messo per iscritto è un compito diverso: richiede di tenere in sospetto proprio la documentazione che si sta leggendo, e andare a cercare il dato grezzo che la smentisce. Claude Code, nelle due sessioni introduttive, restava il più chiaro dei quattro nel separare cosa il progetto eredita da OpenSimulator e cosa aggiunge di suo — ma quella dote non prediceva affatto la seconda: la contraddizione tra i benchmark non versionati e le cifre già pubblicate è un salto di sospetto, non di ordine espositivo. Pi, nella sua prima prova, è rimasto dentro il registro giusto per spiegare anche quando il compito chiedeva di diffidare — senza fallire in modo dichiarato, ha solo riclassificato in silenzio il compito come qualcosa che sapeva già fare bene.
È lo stesso mestiere che faccio quando valuto una fonte prima di scriverne: un testo — che sia un articolo, un README o un commento sopra una funzione — porta sempre l’agenda di chi lo ha scritto, e la domanda utile non è “cosa dice” ma “cosa dà per scontato che io non verifichi”. Il commento sulla cache di compilazione era scritto in perfetta buona fede da chi ha progettato quel pattern concorrente. Era anche sbagliato. Nessuno dei quattro agenti lo ha messo in dubbio finché non gli ho detto esplicitamente: trattalo come un testo da controllare, non come un’autorità da citare.
Nel 2023 il problema era saturo di risposte — quale modello sa più cose, quale allucina meno, quale scrive meglio in italiano — e quelle domande restano legittime, ma sempre più simili a chiedere quale marca di motore sia più potente mentre la vera differenza, su strada, la fa chi guida e su che asfalto. Le intelaiature — l’insieme di sistema di prompt, strumenti collegati, comportamenti predefiniti — decidono se un agente si accontenta della prima risposta plausibile o continua a scavare. E quel comportamento predefinito, l’ho visto con i miei occhi, non è nemmeno fisso: si sposta con una singola frase nel prompt, dalla modalità bibliotecario alla modalità filologo diffidente.
Non è granché come campione: un pomeriggio, un repository, quattro sessioni. Non è un dato statistico, è un aneddoto con la data sopra — e lo dico perché il rischio di innamorarsi della propria narrazione ordinata è alto quando l’esperimento l’hai condotto tu, sulla materia che ti interessa, nel pomeriggio in cui ti aspettavi già di trovarci qualcosa. Prendetelo per quello che è.
C’è anche un dettaglio che mi ha messo in imbarazzo, e che rinforza la tesi più di quanto la indebolisca. A un certo punto ho scambiato la sessione di Antigravity per quella di Claude Code: stessa formattazione a elenco puntato, stesso ritmo di pensiero riportato tra parentesi, stessa cadenza nell’esplorare il repository prima di rispondere. Me ne sono accorto solo perché in fondo al registro compariva un comando di ripresa specifico dello strumento sbagliato. Se la superficie stilistica di due intelaiature costruite da aziende diverse, verosimilmente su modelli diversi, è ormai indistinguibile a uno sguardo distratto, la domanda su quale sia “il modello migliore” perde un altro pezzo di senso: quello che resta visibile e distintivo, alla fine, non è la voce del modello ma il comportamento che l’intelaiatura gli permette o gli impedisce.
Quello che resta, comunque vada la generalizzazione, è che oggi nessuna arena misura questa cosa. LMSYS può far votare a un milione di persone quale risposta suoni meglio a un prompt statico. Non può far votare se un agente ha davvero controllato la concorrenza in un file di duemila righe o si è limitato a ripetere quello che il progetto pensava di sé stesso — per giudicare quello serve conoscere il dominio, non avere un gusto.
Esistono già banchi di prova pensati apposta per gli agenti — SWE-bench, per dire, valuta i modelli su problemi reali presi da segnalazioni e correzioni effettivamente proposte su GitHub. Ma anche lì il limite è strutturale, non un incidente di percorso: il compito resta chiuso, l’ambiente vincolato, e il sospetto che i modelli abbiano già visto quelle stesse segnalazioni durante l’addestramento non si fuga mai del tutto. Misurare se un agente insiste a verificare o si accontenta alla prima difficoltà richiede qualcuno che conosca il dominio abbastanza bene da distinguere una verifica vera da una finta. Resta allora una domanda aperta, e non ho una risposta pulita da offrire: conviene costruire intelaiature con un carattere fisso, diffidente per difetto, o lasciare la calibrazione interamente a chi scrive il prompt volta per volta? Un’intelaiatura sempre sospettosa diventerebbe insopportabile su un refactoring banale. Una sempre accondiscendente continuerà a confermare quello che la documentazione vuole già credere di sé stessa.
Riferimenti
[1] LMSYS Org, Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference, maggio 2023. Lancio della piattaforma, nove modelli iniziali, 4.700 voti nella prima settimana. URL: https://www.lmsys.org/blog/2023-05-03-arena/
[2] Jimenez et al., SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, ICLR 2024. 2.294 problemi presi da issue e pull request reali su 12 repository Python. URL: https://arxiv.org/abs/2310.06770
Leave a Reply